Netdata:每秒采集、自动学基线找异常的开源监控
Netdata 是开源的全栈监控:装完自动发现指标、每秒采集,边缘 ML 为每个指标学基线找异常,告警直发 Slack、Telegram。
项目资料
GitHub Ecosystem- 许可证
- GPL-3.0
- 主语言
- Go
- 星标
- 80,761
- 核查时间
- 2026-09-30
以上快照资料以核查当日为准,可能随版本或运营策略变化。
服务器半夜告警,麻烦的往往不在告警本身,而在定位:通知只说 CPU 高了,你还得挨个打开 CPU、内存、容器、数据库的监控页面找原因。Netdata 把采集、看板和异常发现装进同一个 Agent——2013 年开始开发、Go 编写,截至 2026-09-30 有 80,761 星,一条命令装完就自动发现节点上的系统和应用指标,每秒采集并生成仪表盘。最值得看的是它的异常检测:不要求标注数据,Agent 在节点本地为每个指标滚动训练多个无监督模型,偏离平常的行为会被直接标出来。公众号「AI开源求索」2026-10-01 以「80.8K Star 零配置 AI 监控」为题推荐过它。
核心功能
Netdata 的能力顺着「装完—看数据—出告警」这条线看最清楚。
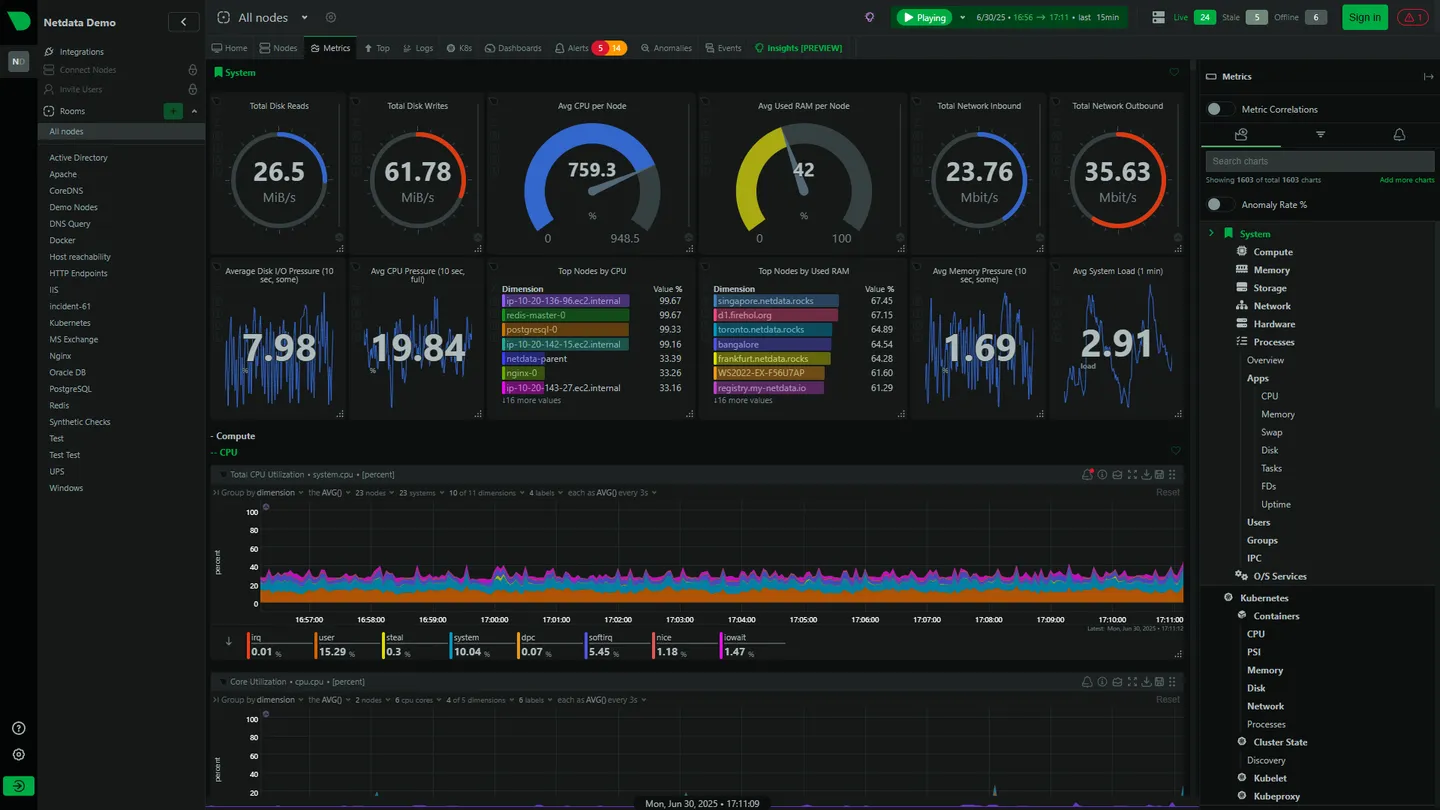
- 零配置自动发现:Agent 启动即扫描所在节点,系统资源、磁盘、网络、进程、容器(Docker、containerd、Kubernetes)连同 nginx、postgres、redis 这类打包应用的指标一起冒出来,官方能力表列出 800+ 集成,不用逐个写采集配置。
- 每秒级粒度:采集和可视化到 1 秒,回看故障时不会被分钟级均值抹平细节;官方在法兰克福、新加坡等地跑着 7 个默认配置的演示站,装之前就能看到真实数据长什么样。
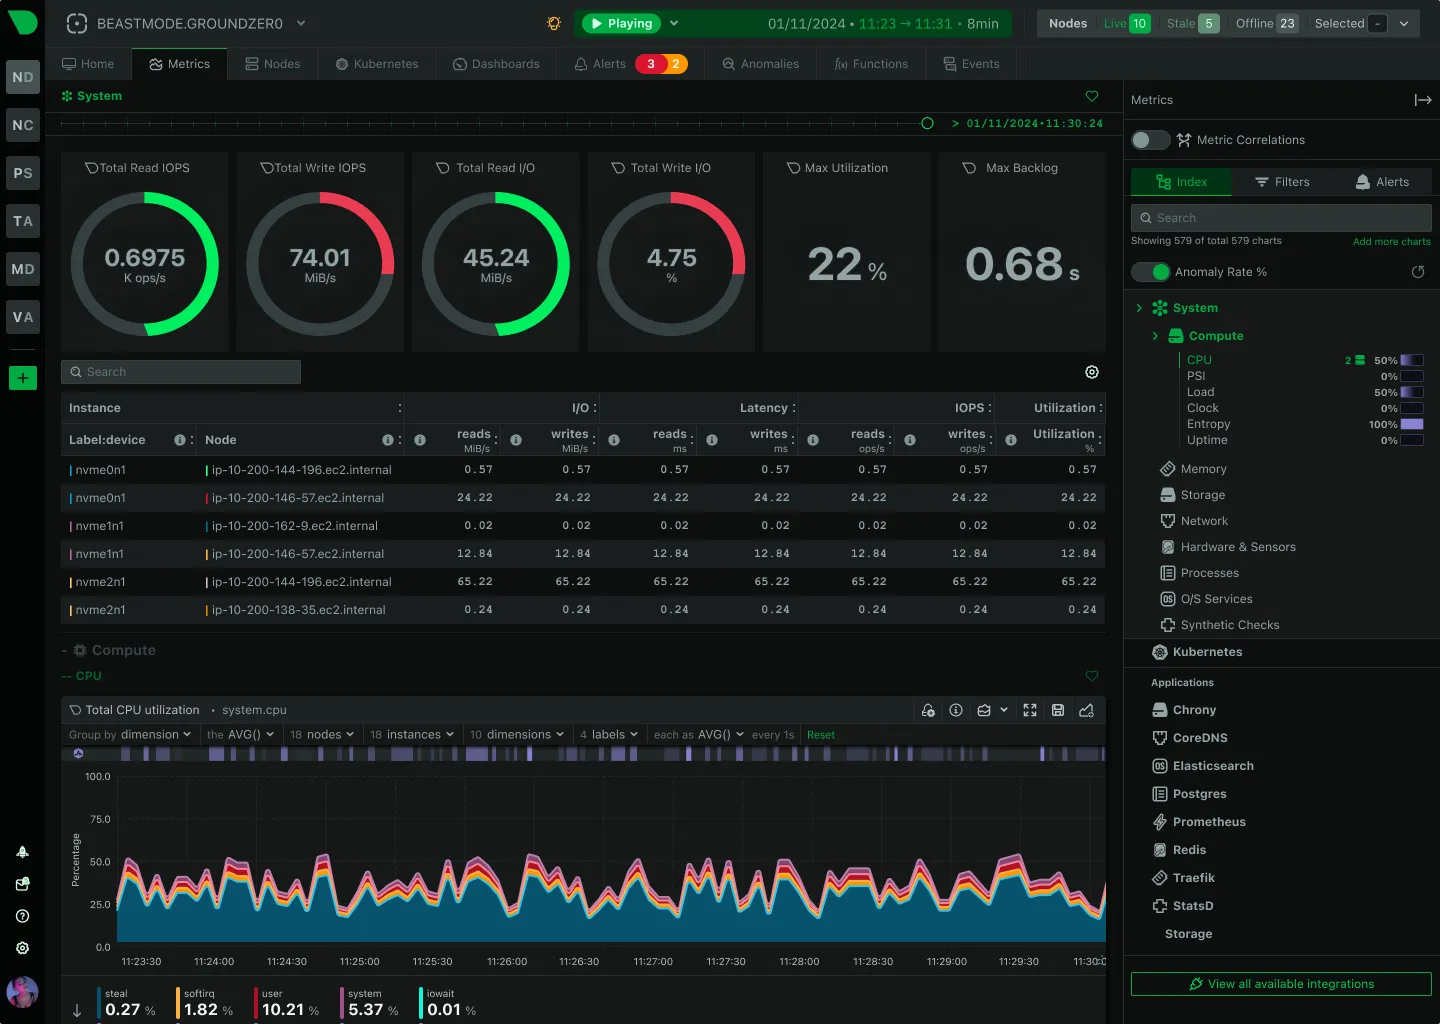
- 边缘 ML 异常检测:每个指标在节点本地训练无监督 k-means 模型,18 个模型各看最近 6 小时、每 3 小时滚动新增,合起来覆盖约 54 小时的行为;全部模型一致才标记异常,官方文档称这样能消除约 99% 的误报,异常率直接叠在每张图表上。
- 预置告警:数百条内置告警规则开箱即用,通知可发 email、Slack、Telegram、PagerDuty、Discord、Microsoft Teams 等,配好 MTA 后 email 默认就能用。
- 省资源的存储:分层存储每样本约 0.5 bytes,Tier 0 每秒、Tier 1 每分钟、Tier 2 每小时三档按缩放级别自动切换查询;README FAQ 给的默认开销是生产系统上约 5% 单核 CPU 加 150MiB 内存,阿姆斯特丹大学 2023 年的研究(ICSOC 论文)把它列为监控 Docker 系统时能效最好的工具。
- 可扩展也能导出:单机看不过来时用 Parent-Child 把多节点汇成集中仪表盘、延长保留期;长期指标可归档到 Prometheus、InfluxDB、Graphite 等。
典型使用场景
Netdata 最常见的用法,是给没有专职运维的机器配上第一套秒级监控。
- 个人开发者和家庭实验室:几台 VPS 或 NAS 各装一个 Agent,浏览器打开
http://localhost:19999看每秒数据,告警推进 Telegram,出事不用再登服务器敲 top。 - 小团队的容器环境:Kubernetes 或 Docker 主机装 Agent 监控容器和节点,再连免费的 Netdata Cloud 社区档,把节点串成一张图、集中告警、给同事开 RBAC 账号,指标本身不集中上云。
- 给 Prometheus 栈补细节:Agent 常驻做秒级采集和边缘异常检测,长期趋势仍归档给 Prometheus;从外部视角给线上站点做体检,可以搭配同站的 Web-Check。
快速上手
Netdata 的安装只有一条命令,官方 kickstart 脚本:
wget -O /tmp/netdata-kickstart.sh https://get.netdata.cloud/kickstart.sh && sh /tmp/netdata-kickstart.sh
装完打开 http://localhost:19999,仪表盘已经填满本节点的每秒指标。偏好容器的话,按官方 Docker 文档挂载宿主文件系统运行:
docker run -d --name=netdata \
  --pid=host \
  --network=host \
  -v netdataconfig:/etc/netdata \
  -v netdatalib:/var/lib/netdata \
  -v netdatacache:/var/cache/netdata \
  -v /:/host/root:ro,rslave \
  -v /etc/passwd:/host/etc/passwd:ro \
  -v /etc/group:/host/etc/group:ro \
  -v /etc/localtime:/etc/localtime:ro \
  -v /proc:/host/proc:ro \
  -v /sys:/host/sys:ro \
  -v /etc/os-release:/host/etc/os-release:ro \
  -v /var/log:/host/var/log:ro \
  -v /var/run/docker.sock:/var/run/docker.sock:ro \
  -v /run/dbus:/run/dbus:ro \
  --restart unless-stopped \
  --cap-add SYS_PTRACE \
  --cap-add SYS_ADMIN \
  --security-opt apparmor=unconfined \
  netdata/netdata
有一点要提前知道:官方安全文档写明,直连 Agent 的访问「通常无认证,依赖局域网隔离或防火墙策略」,建议放在带认证的反向代理后面——19999 端口别裸暴露到公网。
小结
Netdata 适合想立刻拥有秒级监控、又不想自己搭采集和看板的人:个人服务器、家庭实验室、没有专职 SRE 的小团队都覆盖,官方演示站可以先看效果再决定装不装。项目 2013-06-17 创建,2026-09-30 仍有推送,也是 CNCF 成员项目和 CNCF landscape 里星数最多的项目之一。
四点提前说清:异常检测有学习期,18 个模型凑满约 54 小时基线,刚装的头两天判定不完整;跨季度的长期趋势分析,Prometheus、Grafana 生态更成熟,Netdata 的取舍在秒级采集和开箱即用,官方对比博客讲了两边差异,Agent 也支持把指标归档过去互补;Netdata Cloud 的免费社区档管用户、RBAC 和集中告警,但账号体系在云端,要完全离线可以按官方文档关遥测、不连 Cloud、关自动更新;许可要分组件看——Agent 主体 GPL v3+,仪表盘 UI 闭源但免费随 Agent 分发,Cloud 闭源,二次分发或深度集成前先确认。